728x90
Recent Post
SQL 조인, 결국 어떻게 이해하면 되는가
Data Analytics & Insight2025.11.25 10:00SQL 조인, 결국 어떻게 이해하면 되는가

1. 들어가며SQL을 공부하거나 실무에서 데이터를 다루다 보면가장 자주 사용하면서도 의외로 헷갈리는 개념이 JOIN입니다.JOIN은 여러 테이블을 연결해 하나의 결과로 합치는 기능이며,데이터베이스에서 관계형 모델을 사용하는 이유와도 직결됩니다. 아는 것 같으면서도 막상 복잡한 쿼리를 보면 머릿속이 어지러워지기 때문에이번 글에서는 JOIN을 최대한 단순한 관점에서 정리하고자 합니다.2. JOIN이 필요한 이유관계형 데이터베이스는 데이터를 테이블 단위로 나누어 저장합니다. 예를 들어,사용자 정보는 users주문 정보는 orders이렇게 저장됩니다.이 구조의 장점은 중복을 줄이고 데이터 정합성을 유지하기 쉽다는 점입니다.그러나 데이터를 분석할 때는 보통 한 테이블만으로는 충분하지 않습니다. 예시로,“어떤 사용..
ETL vs ELT: 어떤 상황에서 무엇을 선택해야 할까
Data Engineering2025.11.23 10:00ETL vs ELT: 어떤 상황에서 무엇을 선택해야 할까

🎯 들어가며데이터를 다루다 보면 “ETL이 좋다”, “ELT가 요즘 표준이다” 같은 말을 자주 듣습니다.하지만 중요한 건 복잡한 기술용어보다,“우리 상황에서 어떤 방식을 써야 할까?” 라는 현실적인 관점입니다. ETL과 ELT는 결국데이터를 어디에서 가공하느냐의 차이일 뿐이다.ETL: 가져오기 전에 ‘가공’부터 하는 방식Extract → Transform → Load데이터를 가져와서(Extract)변환하고(Transform)정제된 상태로 저장소에 넣는 방식(Load)ETL의 특징변환을 서버(중간 레이어)에서 수행스키마가 명확하고 구조화된 데이터에 유리데이터 정합성을 강하게 보장이런 경우 ETL이 적합운영 DB(OLTP)처럼 구조가 엄격해야 하는 환경데이터가 많지 않아서 중간 처리로도 충분할 때변환 로직..
데이터 모델링의 기본: 왜 스키마가 중요한가
Data Engineering2025.11.19 10:00데이터 모델링의 기본: 왜 스키마가 중요한가

🎯 들어가며데이터를 다룰 때 가장 먼저 떠오르는 건 대시보드, 분석, ETL, AI 모델링 같은 ‘겉으로 보이는 작업들’입니다.하지만 이 모든 것의 가장 바닥에는 스키마(schema), 즉 데이터 구조를 어떻게 설계하느냐가 자리합니다. 스키마는 단순히 테이블의 컬럼 이름을 적는 일이 아닙니다.스키마를 잘 설계하면 데이터가 자연스럽게 ‘흐르는 구조’가 되지만, 스키마가 엉망인 조직은 데이터가 흩어지고, 중복되고, 해석할 수 없게 됩니다. 오늘은 스키마가 왜 중요한지, 그리고 실제로 어떤 기준으로 데이터 모델링을 설계해야 하는지를 정리했습니다.🧩 1. 스키마란 무엇인가?스키마는 데이터가 어떤 형태로 저장되고, 어떠한 관계를 맺고 있는지를 정의한 “데이터의 설계도”입니다.쉽게 말하면,“데이터를 어디에, 어..
💭 데이터는 문제를 해결하기 위한 도구일 뿐 (분석의 목적과 태도에 대한 짧은 성찰)
Reflection, Growth2025.11.15 10:00💭 데이터는 문제를 해결하기 위한 도구일 뿐 (분석의 목적과 태도에 대한 짧은 성찰)

🎯 들어가며데이터를 다루다 보면 종종 착각할 때가 있습니다.마치 “데이터 그 자체”가 문제를 해결해줄 것처럼 느껴질 때. 하지만 실제로는 그 반대이고는 합니다.데이터는 문제를 해결하기 위한 도구일 뿐이며,문제를 정의하지 못한 데이터는 방향 없는 숫자에 불과하지 않을까요?1. 데이터는 ‘답’이 아니라 ‘질문’을 비춘다많은 팀이 데이터를 모으고, 대시보드를 만들고, 수많은 지표를 관리합니다.하지만 정작 가장 중요한 질문은“우리가 지금 무엇을 해결하려 하는가?” 이며,이 질문의 내용을 잊을 때가 많습니다.데이터는 답을 주지 않습니다.대신, 좋은 질문에 대한 단서를 주고는 합니다.질문이 명확하지 않으면, 수치는 늘어나도 인사이트는 늘지 않습니다.결국 좋은 분석가는 데이터를 다루는 사람이 아니라,데이터로 질문을..
🧪 A/B 테스트 설계와 분석 방법 (데이터로 가설을 검증하는 실험의 언어)
Data Analytics & Insight2025.11.14 10:00🧪 A/B 테스트 설계와 분석 방법 (데이터로 가설을 검증하는 실험의 언어)

🎯 들어가며데이터 기반 의사결정의 핵심은 가설을 검증하는 능력입니다.“이 기능이 전환율을 올릴까?”, “새 UI가 리텐션에 도움이 될까?” 이런 질문에 감이 아닌 근거로 답하기 위해 존재하는 게 바로 A/B 테스트입니다.A/B 테스트는 단순한 비교 실험이 아니라, 통계적으로 의미 있는 차이(significant difference) 를 검증하기 위한 구조적인 실험 설계입니다.1. A/B 테스트란 무엇인가A/B 테스트는 사용자 집단을 무작위(Random) 로 나누어 서로 다른 조건(A와 B)을 제공하고, 그 결과를 비교하는 실험입니다.구분설명A 그룹 (Control)기존 버전 — 현재 운영 중인 기능 또는 디자인B 그룹 (Treatment)변경된 버전 — 새 기능 또는 개선안측정 대상전환율, 클릭률, 체..
🔁 Cohort 분석으로 리텐션 이해하기(사용자가 남는 이유를 데이터로 읽는 법)
Data Analytics & Insight2025.11.12 10:00🔁 Cohort 분석으로 리텐션 이해하기(사용자가 남는 이유를 데이터로 읽는 법)

🎯 들어가며서비스 성장의 핵심은 유입이 아니라 유지입니다.유입이 많아도 사용자가 금세 이탈한다면, 결국 데이터는 “일회성 트래픽”으로 사라집니다.그래서 데이터를 볼 때 가장 중요한 질문은“우리의 사용자는 얼마나 오래 남아있는가?” 입니다그리고 이 질문에 가장 명확하게 답할 수 있는 분석 방법이 바로 Cohort 분석입니다.🧩 1. 코호트(Cohort)란 무엇인가‘코호트(cohort)’는 공통된 시점이나 특성을 가진 사용자 집단을 뜻합니다.즉, “언제 가입했는가”, “어떤 경로로 유입되었는가”처럼 공통 조건으로 사용자를 묶고, 그들의 행동 패턴을 추적하는 방식입니다.구분설명예시코호트 단위사용자 그룹을 구분하는 기준가입일, 첫 결제일, 캠페인별 유입측정 대상시간에 따른 행동 유지 여부1일/7일/30일 잔..
🧭 AARRR 퍼널 분석으로 사용자 흐름 이해하기 (데이터로 보는 성장의 여정)
Data Analytics & Insight2025.11.11 09:00🧭 AARRR 퍼널 분석으로 사용자 흐름 이해하기 (데이터로 보는 성장의 여정)

🎯 들어가며서비스 데이터를 다루다 보면 “이탈이 많다”, “유입이 적다”, “활성도가 떨어진다” 같은 표현을 자주 듣습니다.하지만 이 말들 뒤에는 공통된 질문이 있습니다.“사용자는 어디서 오고, 어디서 멈추며, 어디서 돌아오는가?”이 질문에 답하는 게 바로 AARRR 퍼널 분석입니다.오늘은 이 프레임워크를 단순 개념이 아니라 ‘사용자 흐름을 해석하는 데이터 구조’로 정리해보려고 합니다.🧩 1. AARRR이란 무엇인가AARRR은 사용자의 여정을 다섯 단계로 나눈 성장 퍼널 프레임워크입니다.해적처럼 “AARRR!” 소리를 낸다고 해서 ‘Pirate Metrics’라고도 불리기도 합니다.단계의미핵심 질문예시 지표Acquisition사용자가 어떻게 들어오는가어디서 유입되는가?방문자 수, 클릭률, 광고 유입A..
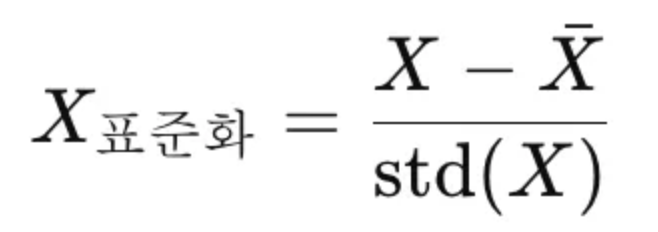
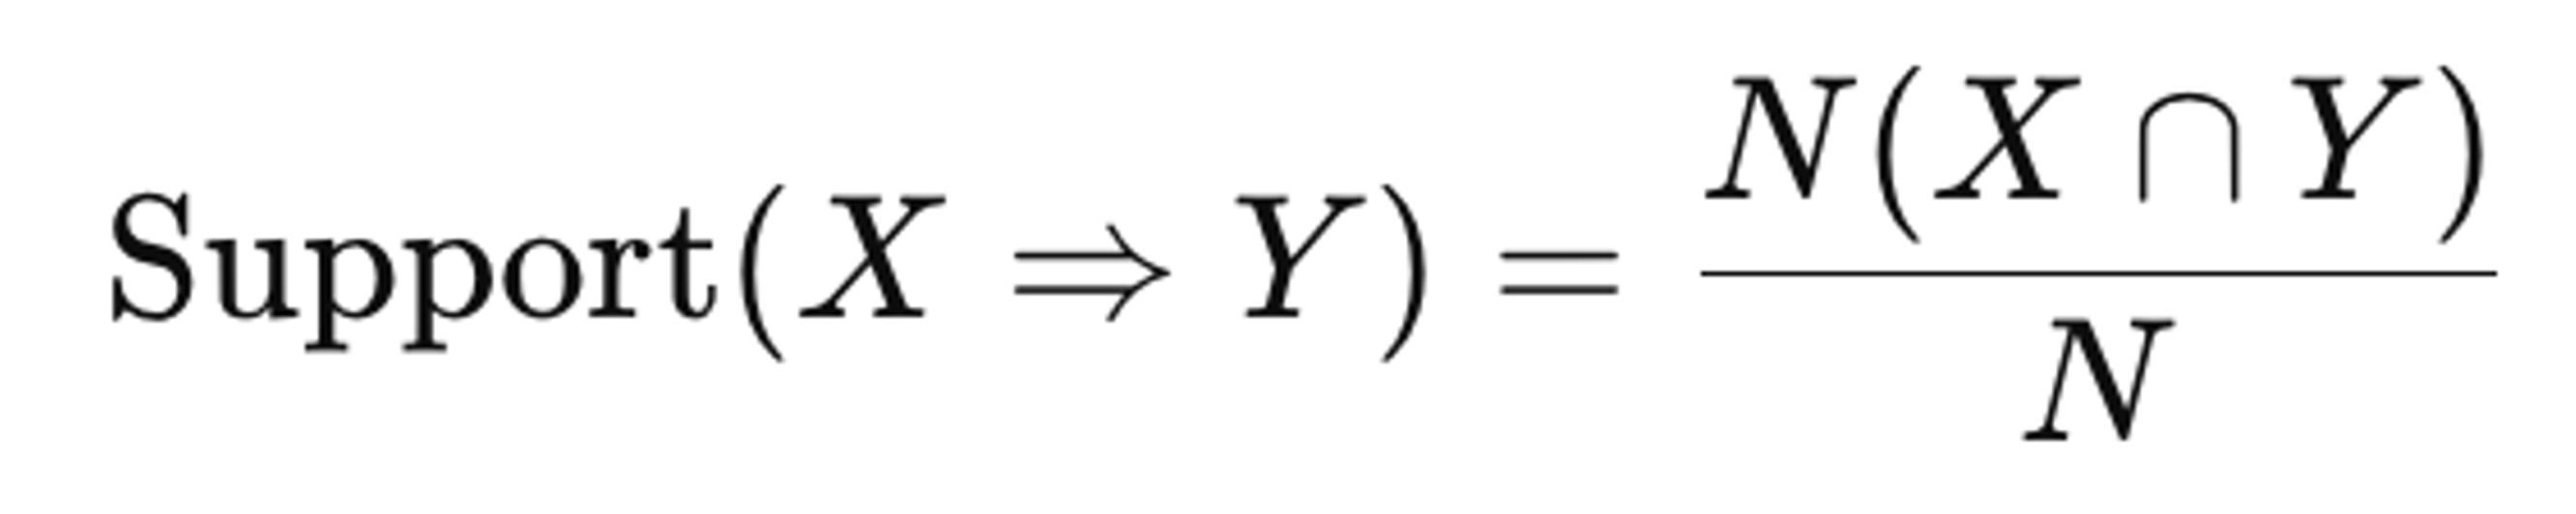
Popular Post
[파이썬을 활용한 통계 개념 기초] 07. 표준화와 정규화(Standardization and Normalization)
[파이썬을 활용한 통계 개념 기초] 07. 표준화와 정규화(Standardization and Normalization)
표준화와 정규화는 스케일링 (Scaling) 기법으로, 데이터의 스케일을 조정하여 모델이 특정 변수에 의존하거나 왜곡된 결과를 내는 것을 방지하고, 더 정확한 예측과 분석을 할 수 있게 돕습니다. 특히 머신러닝과 딥러닝에서 자주 사용됩니다.표준화와 정규화표준화 (Standardization)정의 : 데이터의 평균을 0, 표준편차를 1로 변환하는 기법.목적 : 다양한 변수의 분포와 단위가 다를 때, 동일한 기준으로 변환하여 상대적 비교를 용이하게 합니다.수식 :특징 :평균이 0, 표준편차가 1로 맞춰짐.데이터 분포의 모양은 유지하되, 중심을 0으로 맞추고 스케일을 조정하여, 모든 변수들이 동일한 표준편차를 갖게 함.이상치(Outliers)가 있는 데이터에도 강한 내성을 가질 수 있습니다. (평균 중심의 변..
[데이터 분석 심화 개념] 장바구니 분석 개념 정리 1️⃣ (장바구니 분석의 개념, 연관 규칙 마이닝의 개념과 규칙 평가 지표)
[데이터 분석 심화 개념] 장바구니 분석 개념 정리 1️⃣ (장바구니 분석의 개념, 연관 규칙 마이닝의 개념과 규칙 평가 지표)
데이터 분석
2024.08.12 23:07
이번 글은 코드잇 강의를 수강하면서 배운 내용을 주로 하여 정리되어 있습니다. (코드잇 스프린트 데이터 애널리스트 트랙 1기 훈련생)많은 기업들이 데이터의 중요성을 인식하면서, 데이터를 수집하고 저장하는 데에 상당한 노력을 기울이고 있습니다. 하지만 단순히 데이터를 모아두는 것만으로는 비즈니스 성장을 이끌어낼 수 없습니다. 데이터를 효과적으로 활용하기 위해서는 그 안에서 유용한 정보를 추출해내는 과정이 필수적입니다.예를 들어, 마트에서 고객들의 구매 데이터를 단순히 저장해두기만 한다면, 이는 그저 숫자에 불과할 것입니다. 그러나 이 데이터를 체계적으로 분석해 "매년 8월에는 맥주 매출이 전월 대비 150% 증가한다"는 패턴을 발견했다면 어떻게 될까요? 이를 바탕으로 8월에 맥주를 집중적으로 판매하기 위한..
[분자생물학 기초 개념] 44. 유전자 재조합 및 편집 기술 2️⃣ (유전자 편집 기술, 유전자 재조합 및 편집 기술의 응용)
[분자생물학 기초 개념] 44. 유전자 재조합 및 편집 기술 2️⃣ (유전자 편집 기술, 유전자 재조합 및 편집 기술의 응용)
생명공학 기초
2025.02.05 09:00
유전자 편집 기술 (Gene Editing Technologies)유전자 편집 기술은 특정 유전자 서열을 정밀하게 수정하거나 교정하는 기술로, 생명과학 연구에서 중요한 도구로 자리잡았습니다. 유전자 재조합과 달리, 유전자 편집 기술은 특정 DNA 서열을 직접 타겟팅하여 정밀한 조작을 가능하게 합니다. 유전 질환 치료, 농업, 연구 등 다양한 분야에서 응용되고 있으며, 대표적인 유전자 편집 기술로 CRISPR-Cas9, TALEN, ZFN 등이 있습니다.CRISPR-Cas 시스템 (CRISPR-Cas System)CRISPR-Cas9은 가장 널리 사용되고 있는 유전자 편집 도구입니다. 이 시스템은 박테리아의 면역 시스템에서 발견된 것으로, 바이러스 DNA를 인식하고 이를 절단하여 제거하는 기전에서 유래했습..
[분자생물학 기초 개념] 35. 단백질 구조와 기능 2️⃣ (단백질의 기능적 역할, 단백질의 번역 후 변형, 단백질 구조와 질병)
[분자생물학 기초 개념] 35. 단백질 구조와 기능 2️⃣ (단백질의 기능적 역할, 단백질의 번역 후 변형, 단백질 구조와 질병)
생명공학 기초
2024.11.23 11:32
단백질 구조와 기능은 생명체 내에서 이루어지는 다양한 생화학적 과정의 핵심입니다. 단백질은 아미노산이 결합하여 형성된 고분자로, 그 구조는 1차에서 4차에 이르는 여러 단계로 나누어집니다. 단백질의 구조적 다양성은 그 기능적 특성에 직접적인 영향을 미치며, 효소, 신호 전달, 구조적 지지, 면역 반응 등에서 중요한 역할을 수행합니다.단백질의 기능적 역할 (Functional Roles of Proteins)단백질은 생물체 내에서 매우 다양한 기능을 수행하며, 그 역할은 촉매 작용, 구조적 지지, 운반, 신호 전달, 면역 반응 등 여러 가지로 나눌 수 있습니다. 단백질의 구조는 그 기능적 역할과 밀접하게 연관되어 있으며, 각각의 단백질은 특정 기능을 수행하기 위한 구조적 특징을 가지고 있습니다. 여기서는 ..
[분자생물학 기초 개념] 32. DNA 구조와 기능 1️⃣ (DNA 이중 나선 구조, 염기쌍 형성과 수소 결합, DNA 복제)
[분자생물학 기초 개념] 32. DNA 구조와 기능 1️⃣ (DNA 이중 나선 구조, 염기쌍 형성과 수소 결합, DNA 복제)
생명공학 기초
2024.11.11 09:54
DNA 이중 나선 구조 (Structure of the DNA Double Helix)DNA 이중 나선은 생명체의 유전 정보를 저장하고 전달하는 기본 구조입니다. Watson과 Crick이 1953년에 발표한 이중 나선 모델은 DNA가 어떻게 안정적인 구조로 유지되며, 염기 서열을 통해 유전 정보를 정확하게 전달할 수 있는지 설명합니다. 이 구조는 뉴클레오타이드라는 기본 단위로 이루어지며, 뉴클레오타이드가 모여 이중 나선을 형성합니다. 이 구조는 생물체의 유전적 다양성과 정확한 유전 정보 복제를 가능하게 합니다.Watson-Crick 모델Watson-Crick 모델에 따르면, DNA는 이중 나선(double helix)으로 꼬여 있으며, 두 가닥이 서로 반평행(antiparallel)로 배열되어 있습니다..
[데이터 분석 심화 개념] 장바구니 분석 개념 정리 2️⃣ (연관 규칙 알고리즘)
데이터 분석
2024.08.15 00:06
이번 글은 코드잇 강의를 수강하면서 배운 내용을 주로 하여 정리되어 있습니다. (코드잇 스프린트 데이터 애널리스트 트랙 1기 훈련생)연관 규칙 마이닝Apriori 알고리즘연관 규칙을 찾기 위해 가능한 모든 조합을 시도하는 것은 매우 비효율적입니다. 특히, 상품의 개수가 많아질수록 조합의 수가 기하급수적으로 증가하므로, 이를 다 처리하는 것은 거의 불가능에 가깝습니다. 따라서 가능한 모든 조합을 다 시도하는 무차별 탐색(Brute Force) 방식은 현실적으로 사용하기 어렵습니다.Apriori 알고리즘의 소개상위 조합에서부터 차례로 스캔하면서 특정 조합이 자주 발생하지 않는다면 이의 결과물로 탄생한 후속 조합들까지 모두 후보에서 배제하는 방식의 알고리즘입니다.Apriori 알고리즘을 활용하면 하나의 조합만..
[Git 개념 정리] Git 개념 정리 1️⃣ (Git, Github, Git 다루기)
[Git 개념 정리] Git 개념 정리 1️⃣ (Git, Github, Git 다루기)
Git
2024.07.20 11:22
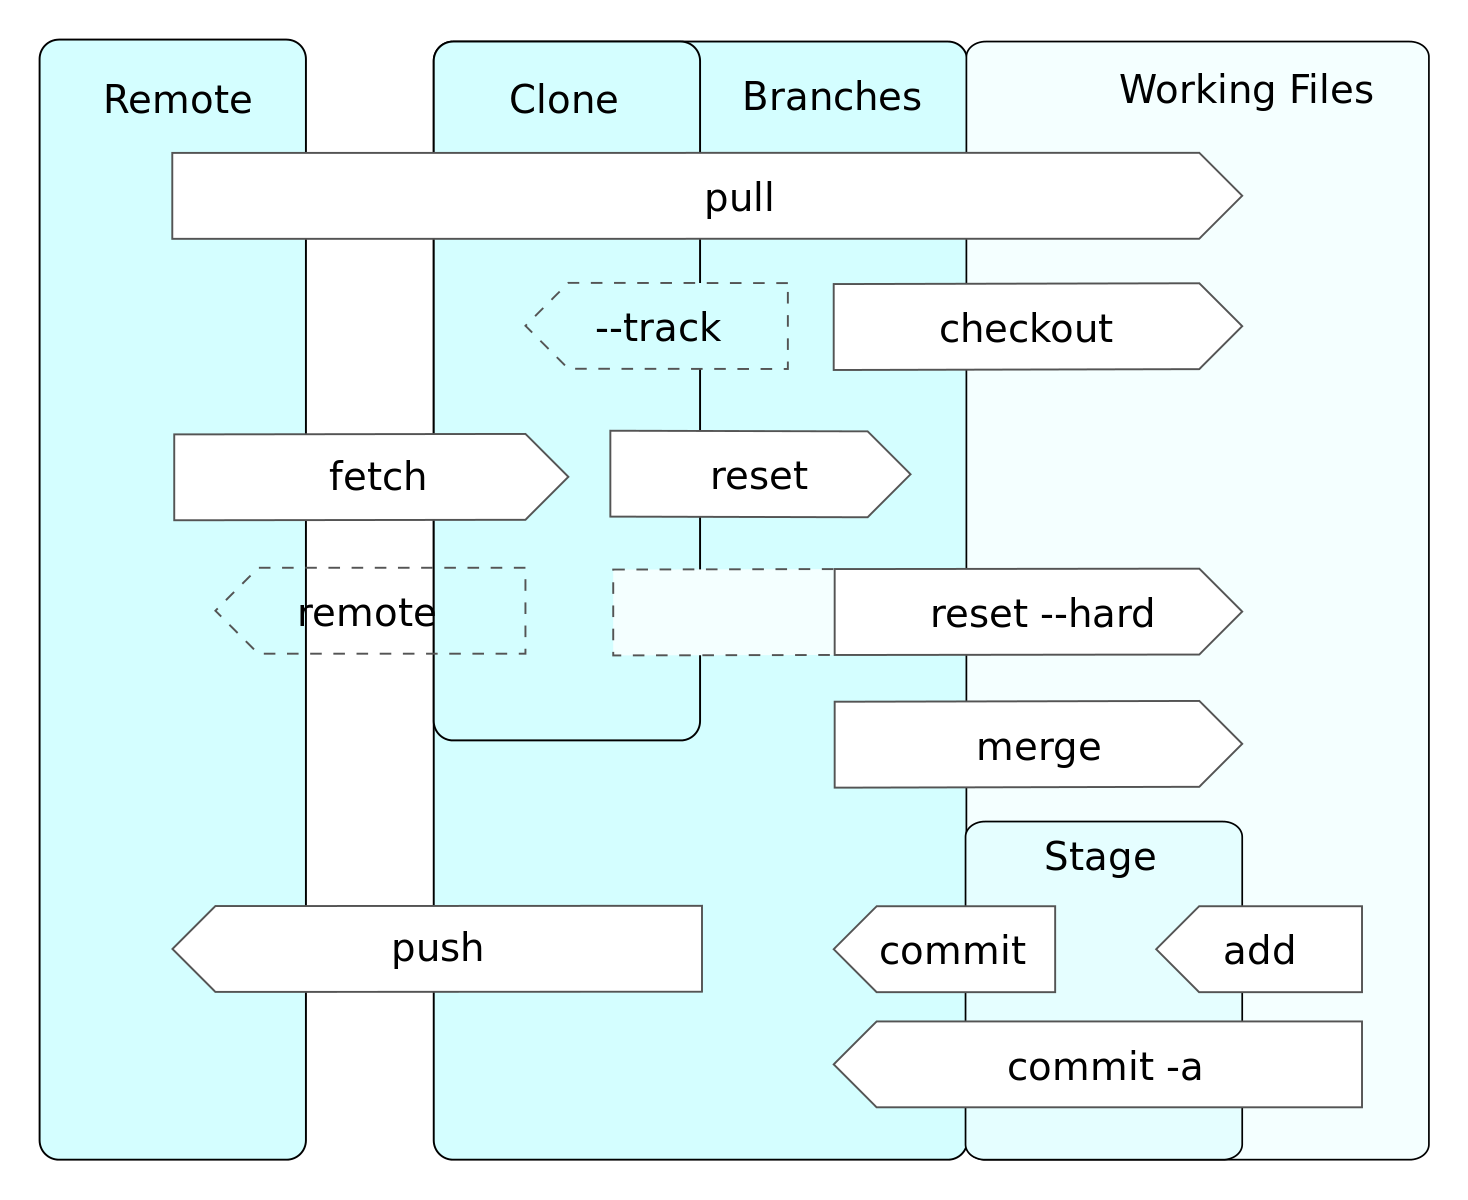
이번 글은 코드잇 강의를 수강하면서 배운 내용을 주로 하여 정리되어 있습니다. (코드잇 스프린트 데이터 애널리스트 트랙 1기 훈련생)Git & Github대부분의 소프트웨어는 수많은 개발자들이 오랜 시간 협업을 통해 만든 결과물입니다.GitGit은 버전관리와 동시협업을 가능하게 해주는 프로그램입니다. (코드 버전 관리 프로그램)버전 관리 : 파일의 변화를 시간에 따라 기록했다가 나중에 특정 시점에 다시 꺼내올 수 있는 시스템입니다.버전 관리의 장점과제의 진짜 최종 버전을 만들 때까지 지난 과정을 확인할 수 있습니다.어딘가 잘못된 부분이 생기면 이전 버전으로 돌아갈 수 있습니다.Git을 이용하면 여러 개발자가 동시에 작성한 코드를 한번에 합칠 수 있습니다.Git의 주요 기능에는 버전 관리, 분산형 저장소,..
300x250
image